Sommaire
Code source du projet : Tous les fichiers (backend, frontend, docker-compose, configuration) sont disponibles sur GitLab : poc_rag - BLOG_V1
1. Introduction
Le Retrieval-Augmented Generation (RAG) est devenu incontournable pour interroger des corpus de documents spécialisés avec de l'IA. Plutôt que de ré-entraîner un modèle de langage (coûteux et chronophage), le RAG combine recherche vectorielle et génération de texte pour obtenir des réponses pertinentes basées sur vos propres documents.
Dans cet article, je partage la construction complète d'un système RAG en production, démontré avec 193 PDFs (5 961 pages) de documentation variée. Cette architecture est applicable à tout domaine spécialisé : juridique, médical, technique, commercial, RH, finance, etc. L'architecture repose sur :
- FastAPI pour l'API REST
- HuggingFace embeddings (all-MiniLM-L6-v2) pour la vectorisation
- Chroma pour la base vectorielle
- Ollama (llama3.1:8b) pour la génération de réponses
- Docker Compose pour l'orchestration
Ce POC illustre les défis réels d'une architecture RAG : isolation réseau Docker, limites de contexte des embeddings, optimisation des performances CPU, et gestion des volumes persistants.
2. Concepts clés
Qu'est-ce que le RAG ?
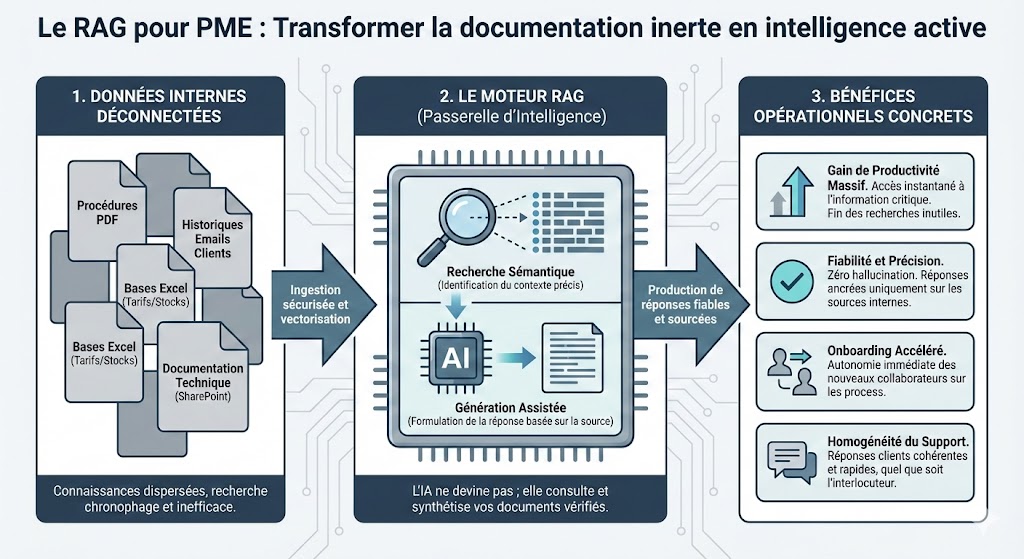
Le Retrieval-Augmented Generation combine deux étapes :
- Retrieval (récupération) : recherche de documents pertinents dans une base vectorielle via similarité sémantique
- Generation (génération) : un LLM utilise ces documents comme contexte pour générer une réponse précise
Pourquoi le RAG pour les domaines spécialisés ?
Les corpus spécialisés évoluent constamment : legislation, standards techniques, documentation interne, recherche médicale, etc. Un modèle de langage classique (même GPT-4) ne connaît pas ces documents spécifiques, n'est pas à jour, ou ne peut pas accéder à vos documents confidentiels.
Le RAG permet de :
- Indexer vos propres documents (privés et confidentiels)
- Garantir la traçabilité des réponses avec sources citées
- Mettre à jour le corpus sans ré-entraînement coûteux
- Fonctionner 100% en local avec des LLM open-source (Ollama)
- Adapter la stratégie de vectorisation à votre domaine
Embeddings : transformer du texte en vecteurs
Les embeddings sont des représentations vectorielles du texte. Deux textes similaires auront des vecteurs proches dans l'espace vectoriel, permettant une recherche de similarité sémantique rapide.
Exemple d'embeddings vectorisés :
"Quelle est la procédure de création SARL?"→ Vector de 384 dimensions [0.23, -0.45, 0.12, ...]"SARL : 2 associés minimum, capital 1€"→ Vector proche du précédent"Comment configurer Docker?"→ Vector très différent (domaine différent)
Dans ce projet, j'utilise all-MiniLM-L6-v2 (HuggingFace) :
- 384 dimensions (léger et rapide)
- Support multilingue (français inclus)
- Fonctionne sur CPU (pas besoin de GPU pour l'embedding)
- ~1 token ≈ 4 caractères (512 tokens max ≈ 2 048 caractères)
3. Implémentation technique
Architecture du système
┌─────────────────────────────────────────────┐
│          POC RAG - Architecture             │
├─────────────────────────────────────────────┤
│                                             │
│  Frontend (nginx:80)                        │
│  ┌───────────────────────────────┐          │
│  │ Interface chat HTML/CSS/JS    │          │
│  └───────────────────────────────┘          │
│                ↓                            │
│  Backend (FastAPI:8000)                     │
│  ┌───────────────────────────────┐          │
│  │ • /api/query (POST)           │          │
│  │ • /health (GET)               │          │
│  │ • /api/refresh (POST)         │          │
│  └───────────────────────────────┘          │
│                ↓                            │
│  RAG System (rag_system.py)                 │
│  ┌───────────────────────────────┐          │
│  │ PyPDFLoader → PDFs            │          │
│  │ CharacterTextSplitter → Chunks│          │
│  │ HuggingFaceEmbeddings         │          │
│  │ Chroma Vector DB              │          │
│  │ RetrievalQA Chain             │          │
│  └───────────────────────────────┘          │
│                ↓                            │
│  Volumes persistants                        │
│  • data/docs/ (193 PDFs)                    │
│  • data/chroma_db/ (base vectorielle)       │
│  • data/huggingface_cache/ (modèle)         │
│                                             │
└─────────────────────────────────────────────┘
                 ↓
    ┌──────────────────────────┐
    │ Ollama LLM (distant)     │
    │ localhost:11434          │
    │ • llama3.1:8b            │
    └──────────────────────────┘
Configuration Docker Compose
Le système est orchestré via Docker Compose avec des volumes persistants pour les données.
version: '3.8'

services:
  backend:
    build: ./backend
    container_name: rag_backend
    ports:
      - "8000:8000"
    environment:
      - OLLAMA_HOST=http://localhost:11434
      - OLLAMA_MODEL=llama3.1:8b
      - DOCS_FOLDER=/app/data/docs
      - DB_FOLDER=/app/data/chroma_db
      - HF_HOME=/root/.cache/huggingface
    volumes:
      - ./data/docs:/app/data/docs
      - ./data/chroma_db:/app/data/chroma_db
      - ./data/huggingface_cache:/root/.cache/huggingface
    command: python -u -m uvicorn main:app --host 0.0.0.0 --port 8000 --log-level debug
    networks:
      - rag_network

  frontend:
    build: ./frontend
    container_name: rag_frontend
    ports:
      - "8080:80"
    depends_on:
      - backend
    networks:
      - rag_network

networks:
  rag_network:
    driver: bridge
Système RAG (rag_system.py)
Le cœur du système gère le chargement des PDFs, le chunking, les embeddings et les requêtes.
from langchain.document_loaders import PyPDFLoader
from langchain.text_splitter import CharacterTextSplitter
from langchain.vectorstores import Chroma
from langchain.embeddings import HuggingFaceEmbeddings
from langchain.llms import Ollama
from langchain.chains import RetrievalQA
from langchain.prompts import PromptTemplate

class MyRag:
    def __init__(self, docs_folder, db_folder, ollama_host, ollama_model,
                 chunk_size=800, chunk_overlap=150,
                 hf_model_name="all-MiniLM-L6-v2",
                 hf_home="/root/.cache/huggingface",
                 hf_device="cpu",
                 llm_temperature=0.7, llm_num_predict=512,
                 top_k_results=3):
        self.docs_folder = docs_folder
        self.db_folder = db_folder
        self.ollama_host = ollama_host
        self.ollama_model = ollama_model
        self.chunk_size = chunk_size
        self.chunk_overlap = chunk_overlap
        self.hf_model_name = hf_model_name
        self.hf_home = hf_home
        self.hf_device = hf_device
        self.llm_temperature = llm_temperature
        self.llm_num_predict = llm_num_predict
        self.top_k_results = top_k_results
        self.db = None
        self.qa_chain = None
        self.ollama_available = False
        self.doc_count = 0

    def initialize(self):
        """Initialiser le RAG"""
        # Charger ou créer la base vectorielle
        if self._db_exists_and_has_data():
            self._load_vector_db()
        else:
            documents = self._load_documents()
            self._create_vector_db(documents)

        # Configurer Ollama
        self._setup_ollama()

    def _load_documents(self):
        """Charger les PDFs"""
        documents = []
        pdf_files = list(Path(self.docs_folder).glob("*.pdf"))

        for pdf_file in pdf_files:
            loader = PyPDFLoader(str(pdf_file))
            docs = loader.load()
            documents.extend(docs)

        return documents

    def _create_vector_db(self, documents):
        """Créer la base vectorielle"""
        # Découpage en chunks
        text_splitter = CharacterTextSplitter(
            chunk_size=800,
            chunk_overlap=150,
            separator="\n"
        )
        chunks = text_splitter.split_documents(documents)

        # Embeddings HuggingFace
        embeddings = HuggingFaceEmbeddings(
            model_name="all-MiniLM-L6-v2",
            cache_folder="/app/data/huggingface_cache",
            model_kwargs={"device": "cpu"}
        )

        # Créer Chroma DB
        self.db = Chroma.from_documents(
            chunks,
            embeddings,
            persist_directory=self.db_folder
        )
        self.db.persist()

    def _setup_ollama(self):
        """Configurer le LLM Ollama"""
        llm = Ollama(
            base_url=self.ollama_host,
            model=self.ollama_model,
            temperature=0.7,
            num_predict=512
        )

        # Prompt générique (adaptable à tout domaine)
        prompt_template = f"""Tu es un assistant expert en {self.domain}.
Utilise les documents fournis pour répondre de manière précise et structurée.

Contexte des documents:
{{context}}

Question: {{question}}

Réponds de manière claire et bien structurée. Cite toujours les sources.
Si l'information n'est pas dans les documents, dis-le explicitement."""

        PROMPT = PromptTemplate(
            template=prompt_template,
            input_variables=["context", "question"]
        )

        # Chaîne RAG
        self.qa_chain = RetrievalQA.from_chain_type(
            llm=llm,
            chain_type="stuff",
            retriever=self.db.as_retriever(search_kwargs={"k": 3}),
            return_source_documents=True,
            chain_type_kwargs={"prompt": PROMPT}
        )

    def query(self, question, k=3):
        """Interroger le système"""
        # Recherche de similarité
        results = self.db.similarity_search(question, k=k)

        # Génération avec LLM
        result = self.qa_chain({"query": question})

        return {
            "answer": result["result"],
            "sources": [
                {
                    "file": Path(doc.metadata["source"]).name,
                    "content": doc.page_content[:300]
                }
                for doc in results
            ]
        }
API FastAPI (main.py)
from fastapi import FastAPI, HTTPException, BackgroundTasks
from fastapi.middleware.cors import CORSMiddleware
from pydantic import BaseModel
from rag_system import MyRag
from config import config
import os

app = FastAPI(
    title="Système RAG - Retrieval-Augmented Generation",
    description="API RAG pour interroger des documents spécialisés",
    version="1.0.0"
)

# Configuration CORS
app.add_middleware(
    CORSMiddleware,
    allow_origins=["*"],  # À restreindre en production
    allow_methods=["*"],
    allow_headers=["*"]
)

# Instance globale du RAG
rag_system = None

@app.on_event("startup")
async def startup_event():
    """Initialisation au démarrage"""
    global rag_system
    print("[INFO] Starting RAG system initialization...")
    try:
        rag_system = MyRag(
            docs_folder=config.DOCS_FOLDER,
            db_folder=config.DB_FOLDER,
            ollama_host=config.OLLAMA_HOST,
            ollama_model=config.OLLAMA_MODEL,
            chunk_size=config.CHUNK_SIZE,
            chunk_overlap=config.CHUNK_OVERLAP,
            hf_model_name=config.HF_MODEL_NAME,
            hf_home=config.HF_HOME,
            hf_device=config.HF_DEVICE,
            llm_temperature=config.LLM_TEMPERATURE,
            llm_num_predict=config.LLM_NUM_PREDICT,
            top_k_results=config.TOP_K_RESULTS
        )
        rag_system.initialize()
        print("[OK] RAG system initialized successfully")
    except Exception as e:
        print(f"[ERROR] Failed to initialize RAG system: {e}")
        raise

class QueryRequest(BaseModel):
    question: str
    k: int = 3

@app.post("/api/query")
async def query(request: QueryRequest):
    """Interroger les documents"""
    global rag_system
    if rag_system is None or rag_system.db is None:
        raise HTTPException(status_code=503, detail="RAG non initialisé")

    try:
        result = rag_system.query(request.question, k=request.k)
        return {
            "question": request.question,
            "answer": result["answer"],
            "sources": result["sources"],
            "model": config.OLLAMA_MODEL
        }
    except Exception as e:
        raise HTTPException(status_code=500, detail=str(e))

@app.get("/health")
async def health_check():
    """Vérifier l'état du système"""
    global rag_system
    if rag_system is None:
        return {
            "status": "initializing",
            "rag_initialized": False,
            "docs_count": 0,
            "ollama_connected": False
        }

    return {
        "status": "healthy",
        "rag_initialized": rag_system.db is not None,
        "docs_count": rag_system.doc_count,
        "ollama_connected": rag_system.ollama_available
    }

@app.post("/api/refresh")
async def refresh_documents(background_tasks: BackgroundTasks):
    """Rafraîchir la base vectorielle"""
    global rag_system
    if rag_system is None:
        raise HTTPException(status_code=503, detail="RAG non disponible")

    background_tasks.add_task(rag_system.refresh)
    return {"message": "Refresh en cours..."}
4. Bonnes pratiques
Chunking optimal
Le découpage des documents est crucial pour la qualité des résultats.
text_splitter = CharacterTextSplitter(
    chunk_size=800,      # Taille du chunk
    chunk_overlap=150,   # Overlap entre chunks (évite perte de contexte)
    separator="\n"       # Découpe sur les retours à la ligne
)
Pourquoi 800 caractères ?
- Compatible avec
all-MiniLM-L6-v2(limite ~512 tokens) - Assez grand pour conserver le contexte sémantique
- Assez petit pour des résultats précis
L'overlap de 150 permet de ne pas couper un concept en deux (ex: un article de loi).
Persistance des données
Les volumes Docker garantissent la persistance des données entre redémarrages :
volumes:
  - ./data/docs:/app/data/docs                          # PDFs sources
  - ./data/chroma_db:/app/data/chroma_db                # Base vectorielle
  - ./data/huggingface_cache:/root/.cache/huggingface  # Modèle embeddings
Après la première initialisation (15-20 minutes), les redémarrages sont instantanés car la base vectorielle est déjà construite.
Gestion des erreurs et fallbacks
if self.qa_chain and self.ollama_available:
    try:
        result = self.qa_chain({"query": question})
        answer = result.get("result", "")
    except Exception as e:
        answer = f"Erreur génération : {e}"
else:
    # Fallback : retourner les chunks pertinents
    answer = "Extraits pertinents :\n\n"
    answer += "\n\n---\n\n".join([doc.page_content[:500] for doc in results])
Si Ollama est inaccessible, le système retourne quand même les chunks pertinents trouvés par la recherche vectorielle.
5. Sécurité
Isolation réseau et données privées
Principe : Vos documents restent sur votre infrastructure. Aucune donnée n'est envoyée à OpenAI ou des services cloud.
Le système fonctionne 100% en local :
- Embeddings :
all-MiniLM-L6-v2téléchargé une fois, puis en cache - Base vectorielle : Chroma DB locale
- LLM : Ollama sur votre réseau local (ou même machine)
CORS et sécurité API
Attention : La configuration actuelle autorise allow_origins=["*"] pour le développement. En production, limitez aux origines autorisées.
app.add_middleware(
    CORSMiddleware,
    allow_origins=[
        "https://votre-domaine.com",
        "https://app.votre-domaine.com"
    ],
    allow_credentials=True,
    allow_methods=["GET", "POST"],
    allow_headers=["*"]
)
Variables d'environnement sensibles
Ne jamais hardcoder les configurations dans le code :
OLLAMA_HOST=http://localhost:11434
OLLAMA_MODEL=llama3.1:8b
DOCS_FOLDER=/app/data/docs
DB_FOLDER=/app/data/chroma_db
HF_HOME=/root/.cache/huggingface
HF_MODEL_NAME=all-MiniLM-L6-v2
HF_DEVICE=cpu
Rate limiting et validation des entrées
Pour une API en production, ajoutez du rate limiting :
from slowapi import Limiter, _rate_limit_exceeded_handler
from slowapi.util import get_remote_address

limiter = Limiter(key_func=get_remote_address)
app.state.limiter = limiter

@app.post("/api/query")
@limiter.limit("10/minute")  # Max 10 requêtes/minute
async def query(request: Request, query_request: QueryRequest):
    # ...
6. Cas d'usage réel
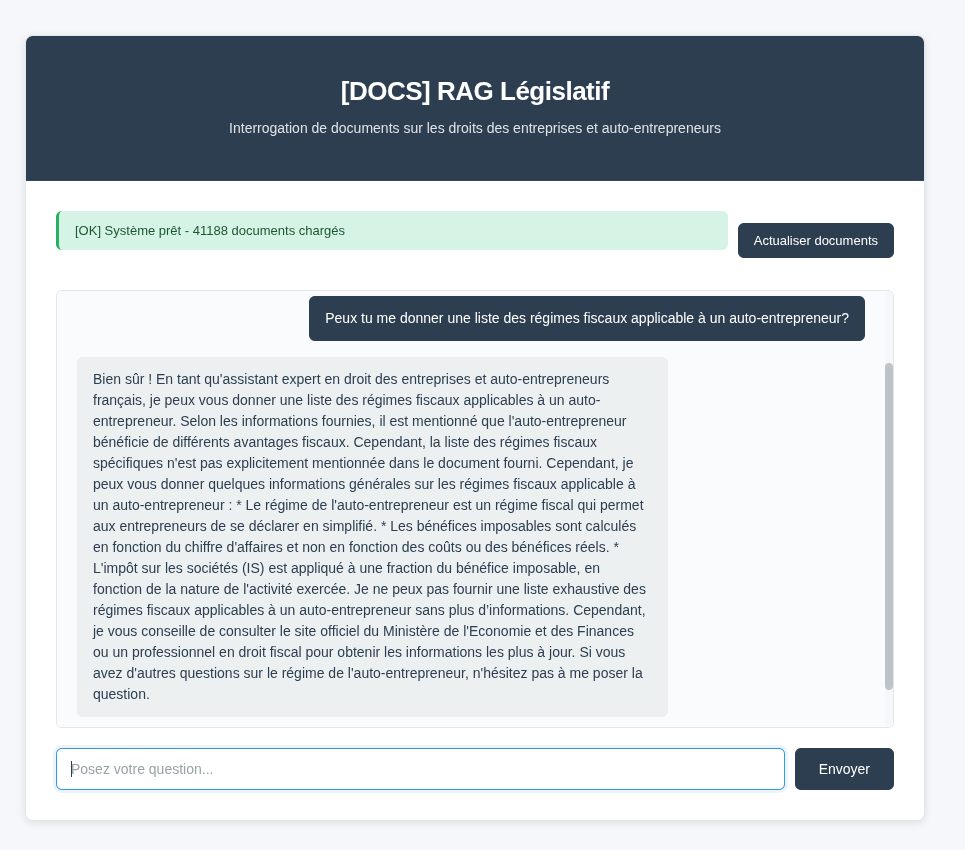
Voici l'interface en action avec un corpus réel de documents juridiques :
Requêtes testées - Exemples variés
Voici des exemples de requêtes réelles dans différents domaines :
Question : "Quelles sont les obligations fiscales d'un auto-entrepreneur?"

Réponse :
Selon la documentation, les obligations fiscales incluent :

1. Déclaration du chiffre d'affaires mensuelle ou trimestrielle
2. Versement libératoire de l'impôt sur le revenu (optionnel)
3. CFE (Cotisation Foncière des Entreprises) dès la 2ème année
4. TVA non applicable sous certains seuils (franchise en base)
5. Tenue d'un livre de recettes

Sources : auto-entrepreneur-guide.pdf (pages 12-15)Question : "Quels sont les protocoles de traitement pour une infection bactérienne?"
Réponse :
Selon les protocoles médicaux standards :
1. Diagnostic clinique et confirmation par culture
2. Sélection d'antibiotique approprié (selon antibiogramme)
3. Dosage optimal selon le site d'infection
4. Durée de traitement : généralement 7-14 jours
5. Suivi et test de sensibilité bactérienne
Sources : medical-protocols-2025.pdf (pages 34-41)Question : "Comment configurer un cluster Kubernetes haute disponibilité?"
Réponse :
Les étapes principales pour configurer un cluster HA :
1. Déployer au moins 3 nœuds master (etcd + API server)
2. Configurer load balancer devant les master nodes
3. Mettre en place persistance etcd avec sauvegarde
4. Implémenter health checks et auto-recovery
5. Monitorer avec Prometheus + Grafana
Sources : kubernetes-production-guide.pdf (pages 56-72)Performances observées
7. Conclusion
Ce POC démontre qu'il est possible de créer un système RAG complet et fonctionnel pour des documents spécialisés (ici, le droit français) en combinant des outils open-source :
- FastAPI pour une API REST performante
- HuggingFace embeddings pour la vectorisation (sans GPU)
- Chroma pour une base vectorielle légère et persistante
- Ollama pour un LLM local et privé
- Docker Compose pour un déploiement reproductible
Résultats clés
Évolutions possibles
- GPU pour embeddings : Réduire le temps de génération (15-20 min → 2-3 min)
- Hybrid search : Combiner recherche vectorielle + recherche par mots-clés (BM25)
- Filtrage par métadonnées : Date, source, type de document
- Historique des requêtes : PostgreSQL pour tracking et analytics
- Interface avancée : React + streaming des réponses (SSE)
- Multi-tenancy : Bases vectorielles séparées par client
Prochaine étape : Je prévois d'ajouter un système de feedback utilisateur pour améliorer le retrieval (re-ranking des résultats basé sur les retours).
Ressources
- LangChain Documentation
- Chroma - Base vectorielle
- all-MiniLM-L6-v2 (HuggingFace)
- Ollama - LLM local
- FastAPI
Note : Ce guide est entièrement générique et applicable à tout domaine spécialisé : juridique, médical, technique, commercial, financier, académique, etc. L'architecture et le code fournissent une base solide que vous pouvez adapter à votre corpus spécifique.
Gestion Incrémentale des Documents
Une des forces du système implémenté est sa capacité à gérer l'ajout de nouveaux PDFs de manière incrémentale, sans recalculer les embeddings des documents déjà indexés.
Procédure pour ajouter des PDFs
Approche simple : Copier les PDFs dans le dossier `/data/docs/` et redémarrer le conteneur. Le système détecte automatiquement les nouveaux fichiers au démarrage et les indexe.
// Étape 1 : Copier les PDFs
cp /chemin/vers/mes/documents.pdf /data/docs/

// Étape 2 : Redémarrer le conteneur
docker-compose restart backend

// Étape 3 : Vérifier l'état
curl http://localhost:8000/health
Optimisation : Indexation Incrémentale
Le système utilise une détection par hash MD5 pour identifier les nouveaux documents :
- Au démarrage : Scan automatique des PDFs du disque, comparaison avec les fichiers indexés dans Chroma, ajout UNIQUEMENT des nouveaux
- À la demande : Endpoint
/api/refreshpour synchroniser sans redémarrage - Détection de modifications : Si un PDF est modifié (contenu change), le hash diffère et le fichier est ré-indexé
Performances
Comparaison avec un refresh complet (avant optimisation) :
Avec l'indexation incrémentale, l'ajout de 10 nouveaux PDFs à un corpus de 200 ne recalcule que les embeddings des 10 nouveaux, gagnant ainsi ~5 minutes de calcul.
API Endpoint
Pour déclencher la synchronisation sans redémarrage :
POST /api/refresh

# Réponse
{
  "message": "Refresh en cours..."
}

# Vérifier l'état
GET /health
{
  "status": "healthy",
  "rag_initialized": true,
  "docs_count": 220,
  "ollama_connected": true
}
L'interface dispose également d'un bouton "Actualiser" pour déclencher le refresh directement depuis le frontend, sans passer par des appels cURL.
Astuce : Pour un corpus volumineux, regroupez les ajouts de PDFs et lancez un seul refresh plutôt que plusieurs petits redémarrages. Cela amortit le coût de calcul.
Vous avez des questions ou un sujet technique à explorer ?
Ce guide couvre les fondations, mais chaque projet RAG est unique. Que ce soit pour optimiser les embeddings, améliorer la latence, ou adapter l'architecture à votre cas spécifique, je suis ouvert à discuter de vos défis techniques.
Partagez votre question ou sujet via le formulaire de contact et je répondrai avec des insights adaptés à votre contexte.
P.S. - Debug & Résolution des problèmes courants
Problème : Isolation réseau Docker (HuggingFace inaccessible)
Si votre conteneur ne peut pas télécharger le modèle HuggingFace :
Étape 1 : Télécharger sur la machine hôte
python -c "from transformers import AutoTokenizer; AutoTokenizer.from_pretrained('sentence-transformers/all-MiniLM-L6-v2')"

Étape 2 : Monter le cache dans docker-compose.yml
volumes:
  - ~/.cache/huggingface:/root/.cache/huggingface

Étape 3 : Configuration HuggingFaceEmbeddings
embeddings = HuggingFaceEmbeddings(
    model_name="all-MiniLM-L6-v2",
    cache_folder="/app/data/huggingface_cache",
    model_kwargs={"device": "cpu"}
)
Autres problèmes fréquents
- Limite de contexte : OllamaEmbeddings limité à 512 tokens. Solution : passer à HuggingFace (flexible)
- Performance CPU lente : Chunking de 800 caractères optimal. Utilisez GPU si disponible
- Chroma persistence : Créer les dossiers /data/chroma_db/ avant le démarrage