L'extraction automatique de données depuis des tickets de caisse et factures est un cas d'usage classique en entreprise. Traditionnellement, on utilise des pipelines OCR complexes (Tesseract + regex + NLP). Dans ce POC, j'ai testé une approche radicalement différente : envoyer directement l'image à un modèle de vision LLM et lui demander d'extraire les données en JSON.
Résultats : ça marche. Mais tous les modèles ne se valent pas. Voici le benchmark complet de 4 modèles vision sous Ollama, avec résultats détaillés et code d'implémentation.
Sommaire
Le problème à résoudre
Automatiser l'extraction de données depuis des notes de frais : tickets de restaurant, factures, reçus. L'objectif est d'extraire :
- Montant TTC - le total à payer
- Date - quand l'achat a été fait
- Fournisseur - nom du commerce
- Catégorie - restauration, transport, hotel...
- Score de confiance - fiabilité de l'extraction
Approche traditionnelle vs Full LLM
Image -> Tesseract (OCR) -> Texte brut -> Regex/NLP -> JSON
                         ^                        ^
                    Configuration           Règles complexes
par langue maintenance lourdeImage -> Modèle Vision (qwen2.5vl) -> JSON structure
^
Un seul prompt
Zero configurationL'approche Full LLM élimine toute la complexité du preprocessing. Le modèle "voit" l'image et extrait directement les informations demandées.
Architecture "Full LLM"
Le POC utilise une architecture minimaliste :
- Backend : FastAPI (Python)
- LLM : Ollama sur serveur distant (RTX 3080, 10GB VRAM)
- Modèle : qwen2.5vl:7b (gagnant du benchmark)
- Formats : JPG, PNG, PDF (converti en image via PyMuPDF)
Prérequis : Ollama accessible sur le réseau avec un modèle vision chargé. Voir mon article Ollama en tant que service réseau local pour la configuration.
Benchmark des modèles vision
J'ai testé 4 modèles vision disponibles sous Ollama sur 3 fichiers de test :
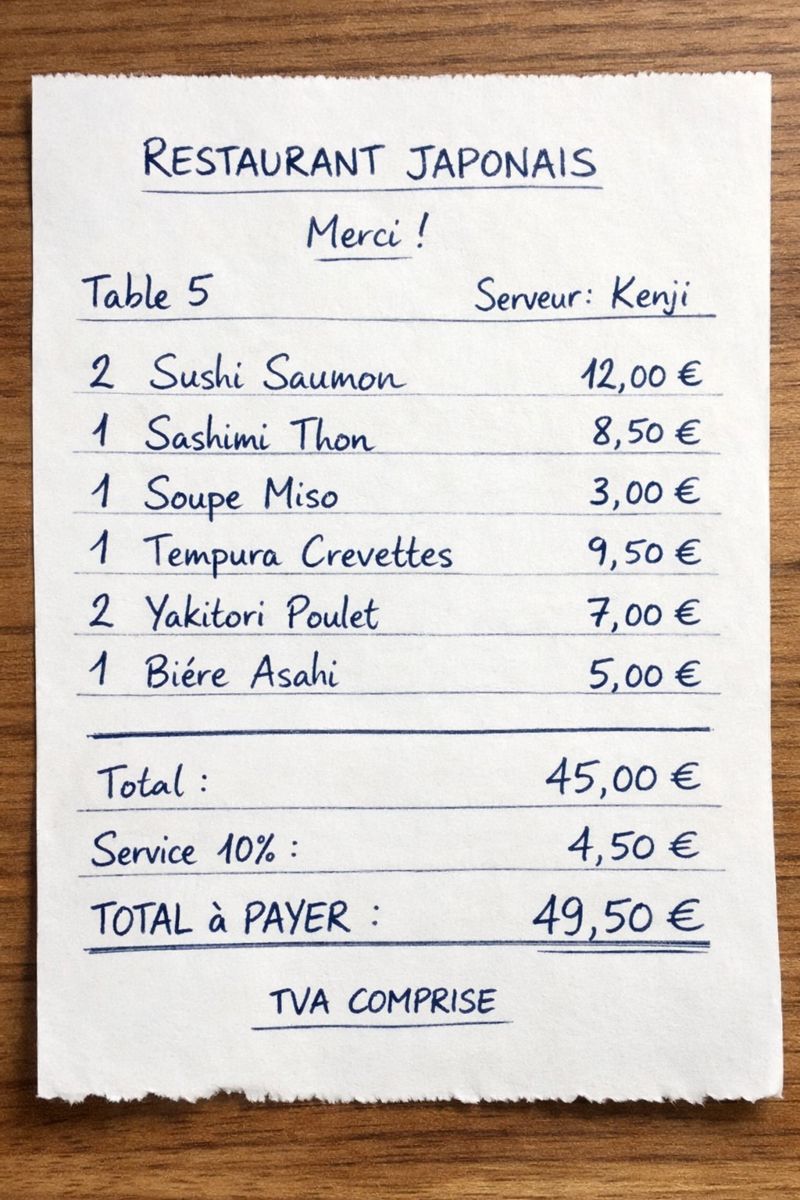
Ticket restaurant (49.50 EUR)
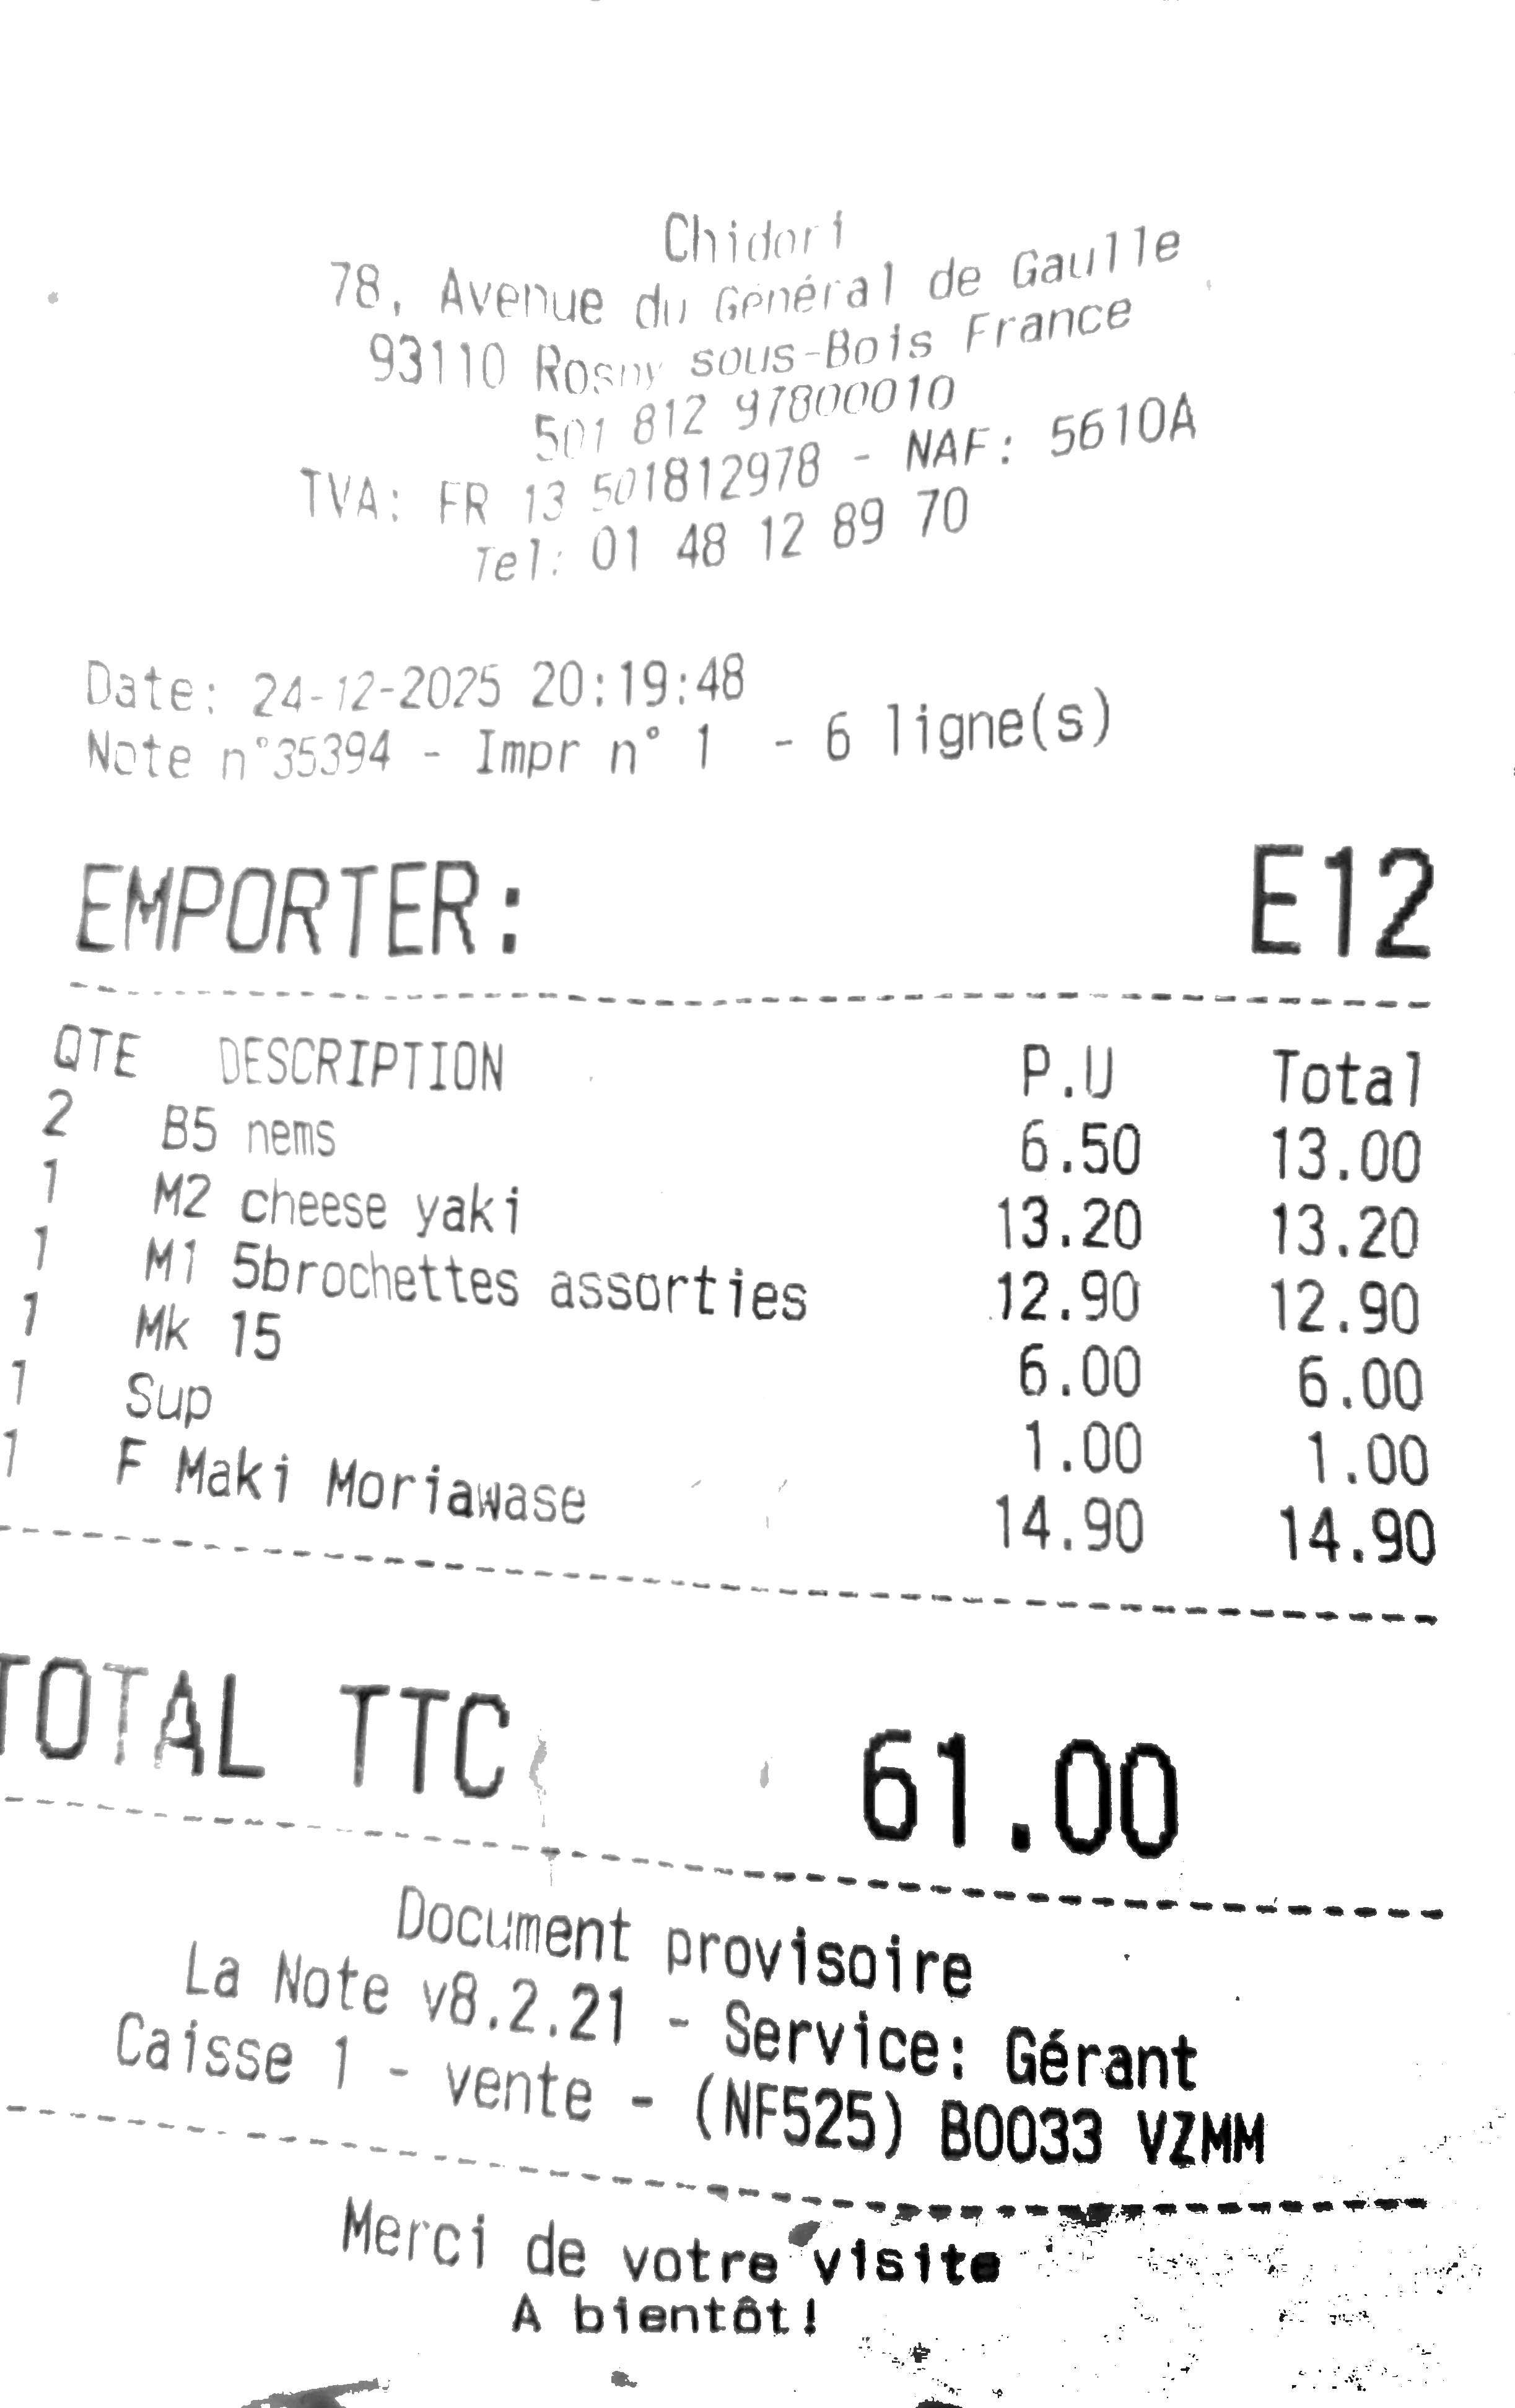
Ticket thermique (61.00 EUR)
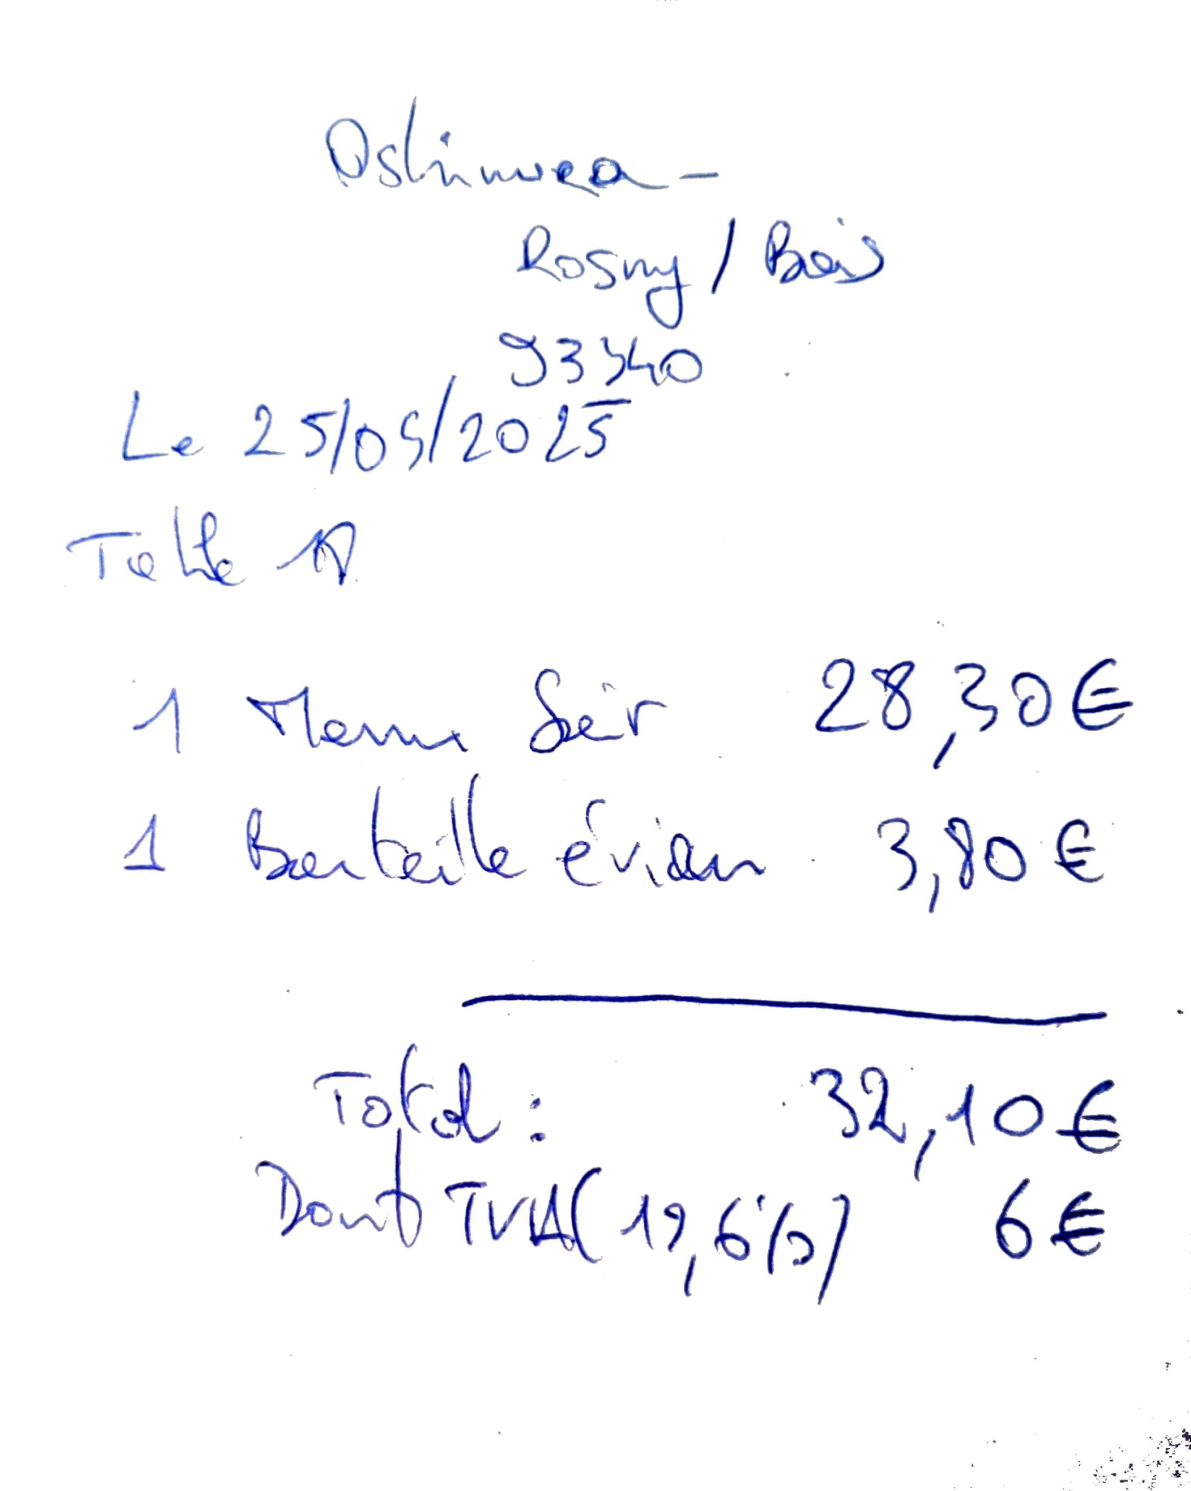
Facture manuscrite (32.10 EUR)
| Modèle | Score | Temps | Montant OK | Fournisseur OK |
|---|---|---|---|---|
| qwen2.5vl:7b | 0.84 | 78.9s | 3/3 | 1/3 |
| llava:13b | 0.57 | 31.1s | 0/2 | 1/2 |
| minicpm-v | 0.56 | 14.0s | 2/3 | 1/3 |
| bakllava | 0.00 | N/A | 0/0 | 0/0 |
qwen2.5vl:7b est le grand gagnant avec un score de 0.84. Il est plus lent que les autres (78.9s total pour 3 fichiers) mais nettement plus précis sur l'extraction des montants.
Critères d'évaluation
- Montant : le champ le plus critique. Doit être exact à l'euro près.
- Fournisseur : reconnaissance du nom du commerce (tolérant aux variations mineures).
- Date : format YYYY-MM-DD attendu.
- Catégorie : classification parmi 6 catégories prédéfinies.
Résultats détaillés
Test 1 : Ticket restaurant japonais (image claire)
Montant attendu : 49.50 EUR
| Modèle | Montant extrait | Résultat |
|---|---|---|
| qwen2.5vl:7b | 49.5 | [OK] |
| minicpm-v | 49.5 | [OK] |
| llava:13b | 45.05 | [ERREUR] |
Test 2 : Ticket de caisse réel (thermique)
Montant attendu : 61.00 EUR - Ce ticket est plus difficile : impression thermique, contraste variable.
| Modèle | Montant extrait | Résultat |
|---|---|---|
| qwen2.5vl:7b | 61.0 | [OK] |
| minicpm-v | 61.0 | [OK] |
| llava:13b | 6.0 | [ERREUR] |
llava:13b a lu "6.0" au lieu de "61.0" - une erreur de lecture du chiffre des dizaines. Ce type d'erreur est critique pour une application de notes de frais.
Test 3 : Facture manuscrite PDF
Montant attendu : 32.10 EUR - Le cas le plus difficile : écriture manuscrite, PDF converti en image.
| Modèle | Montant extrait | Résultat |
|---|---|---|
| qwen2.5vl:7b | 32.1 | [OK] |
| minicpm-v | 3210.0 | [ERREUR] |
| llava:13b | N/A (crash) | [ERREUR] |
qwen2.5vl:7b est le seul modèle à avoir correctement extrait les 3 montants. Sa capacité à lire les écritures manuscrites est impressionnante.
Implémentation Python
Le prompt d'extraction
Le coeur du système est le prompt envoyé au LLM. Il doit être précis pour obtenir un JSON valide :
EXTRACTION_PROMPT = """Analyze this receipt/invoice image and extract ONLY visible information.

CRITICAL: Only extract information that is CLEARLY VISIBLE on the receipt.
DO NOT invent, guess, or hallucinate any data. If a field is not visible, use null.

Return ONLY valid JSON with this exact structure:
{
    "montant": <total amount TTC as number or null>,
    "tva_montant": <VAT amount as number if visible, or null>,
    "devise": "<currency code EUR/USD/etc or null>",
    "date": "<date in YYYY-MM-DD format or null>",
    "fournisseur": "<merchant name exactly as written or null>",
    "lieu": "<address/city ONLY if printed on receipt, otherwise null>",
    "catégorie": "<restauration|transport|hotel|fournitures|carburant|autre>",
    "description": "<items purchased, based on receipt content>",
    "confiance": <0.0 to 1.0>
}

IMPORTANT: Return null for any field where information is NOT clearly visible.
Return ONLY the JSON, no explanation."""
Classe LLMExtractor
import base64
import io
import json
import re
import httpx
from PIL import Image
import fitz  # PyMuPDF

class LLMExtractor:
    def __init__(self, base_url: str, model: str, timeout: int = 120):
        self.base_url = base_url.rstrip("/")
        self.model = model
        self.timeout = timeout

    def _preprocess_image(self, image_data: bytes, max_size: int = 1500) -> bytes:
        """Resize large images to avoid model crash."""
        img = Image.open(io.BytesIO(image_data))
        if img.mode in ("RGBA", "P"):
            img = img.convert("RGB")

        if img.width > max_size or img.height > max_size:
            ratio = min(max_size / img.width, max_size / img.height)
            new_size = (int(img.width * ratio), int(img.height * ratio))
            img = img.resize(new_size, Image.Resampling.LANCZOS)

        output = io.BytesIO()
        img.save(output, format="PNG", optimize=True)
        return output.getvalue()

    def _pdf_to_image(self, pdf_data: bytes, dpi: int = 200) -> bytes:
        """Convert first page of PDF to PNG."""
        doc = fitz.open(stream=pdf_data, filetype="pdf")
        page = doc[0]
        zoom = dpi / 72
        pixmap = page.get_pixmap(matrix=fitz.Matrix(zoom, zoom))
        return pixmap.tobytes("png")

    def extract_from_bytes(self, file_data: bytes) -> dict:
        # Convert PDF to image if needed
        if file_data[:4] == b"%PDF":
            image_data = self._pdf_to_image(file_data)
        else:
            image_data = file_data

        # Resize large images (avoid model crash)
        image_data = self._preprocess_image(image_data, max_size=1500)

        # Encode and send to Ollama
        image_b64 = base64.b64encode(image_data).decode("utf-8")

        payload = {
            "model": self.model,
            "prompt": EXTRACTION_PROMPT,
            "images": [image_b64],
            "stream": False,
        }

        response = httpx.post(
            f"{self.base_url}/api/generate",
            json=payload,
            timeout=self.timeout
        )
        response.raise_for_status()

        # Parse JSON from LLM response
        llm_response = response.json()["response"]
        result = self._parse_json_response(llm_response)
        return self._validate_result(result)
Preprocessing important : les images trop grandes (> 1500px) font crasher qwen2.5vl. Le preprocessing avec redimensionnement est essentiel.
Fonction extract_receipt
Point d'entrée simple pour l'extraction :
# Instance par défaut avec config depuis variables d'environnement
extractor = LLMExtractor(
    base_url=os.getenv("OLLAMA_BASE_URL", "http://192.168.0.240:11434"),
    model=os.getenv("OLLAMA_MODEL", "qwen2.5vl:7b"),
    timeout=int(os.getenv("OLLAMA_TIMEOUT", "120"))
)

def extract_receipt(file_data: bytes) -> dict:
    """
    Extract receipt data from file bytes (JPG, PNG, or PDF).

    Args:
        file_data: Raw file bytes

    Returns:
        dict with: montant, devise, date, fournisseur, lieu,
                   catégorie, description, confiance
    """
    return extractor.extract_from_bytes(file_data)
Endpoint FastAPI
@app.post("/extract")
async def extract_from_file(
    file: UploadFile = File(...),
    api_key: str = Depends(verify_api_key),
):
    # Validate file type
    allowed_types = ["image/jpeg", "image/png", "application/pdf"]
    if file.content_type not in allowed_types:
        raise HTTPException(status_code=400, detail="Invalid file type")

    file_data = await file.read()

    result = extract_receipt(file_data)
    return {
        "status": "success",
        "filename": file.filename,
        "extraction": result,
    }
Conclusion et prochaines étapes
L'approche "Full LLM" pour l'OCR de documents fonctionne. Le modèle qwen2.5vl:7b offre une précision de 84% sur notre benchmark, avec une extraction parfaite des montants sur les 3 fichiers testés.
Points clés du POC
- Architecture simplifiée : pas de Tesseract, pas de regex, pas de NLP
- qwen2.5vl:7b est le meilleur modèle vision testé (score 0.84)
- Preprocessing obligatoire : resize images > 1500px
- Support PDF via conversion en image (PyMuPDF)
- Temps de réponse : ~25 secondes par document
Prochaines étapes
Ce POC valide l'approche. La suite du projet inclut :
- Multi-workflow : prompts personnalisés par client/cas d'usage
- Règles de validation : plafonds par catégorie, regles conditionnelles
- Interface admin : configuration des workflows sans code
- Base de données : historique des extractions, audit
Le code source complet est disponible sur GitLab.